Category: Technische Kommunikation

  • Benutzerhandbücher neu aufsetzen

    Benutzerhandbücher neu aufsetzen

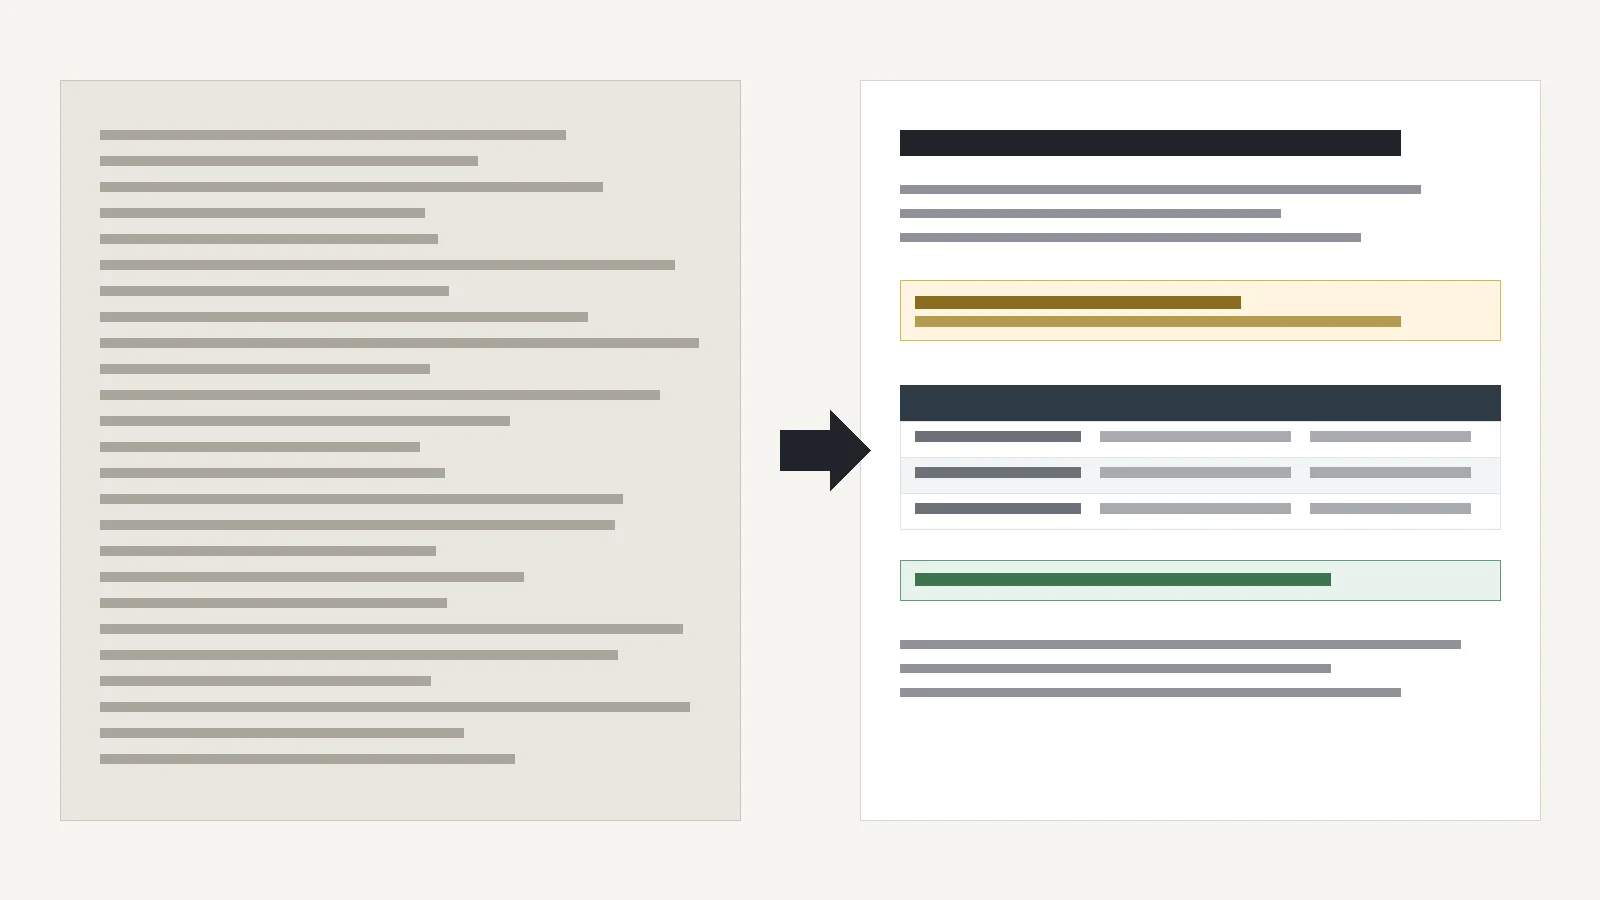
    Die Handbücher, die ich für Kunden erstelle, unterliegen NDAs, deshalb zeigt dieser Beitrag denselben Prozess an öffentlichem Material. Ich habe ein dichtes Kapitel echter technischer Dokumentation genommen, Kapitel 3 von DocBook 5.2: The Definitive Guide von Norman Walsh (XML Press, frei verfügbar auf tdg.docbook.org), und es so umstrukturiert, wie ich eine Handbuch-Überarbeitung angehe.

    Was die Überarbeitung leistet

    • Verdichtet den Konzepttext zu einer erfassbaren Übersicht mit einer Zusammenfassung auf einen Blick
    • Hebt den ID/IDREF-Hinweis aus einer Absatz-Nebenbemerkung in einen Callout
    • Wandelt die Werkzeugübersicht in eine Vergleichstabelle mit kopierbarem Befehl um
    • Baut die drei Fehlerbeispiele als Symptom-Ursache-Lösung-Referenz neu auf
    • Kondensiert die Codelistings; der technische Inhalt bleibt unverändert

    Das überarbeitete Kapitel

    DocBook-Dokumente validieren

    Ein DocBook-Dokument ist nur dann DocBook, wenn es validiert. Die Validierung prüft die exakte Reihenfolge und Verschachtelung jedes Elements gegen das Schema. Dieses Kapitel behandelt, was die Validierung erzwingt, welche Werkzeuge sich eignen und wie man die Fehlermeldungen liest, wenn ein Dokument scheitert.

    Auf einen Blick
    Die Validierung läuft nach dem Parsen: Das Dokument muss bereits wohlgeformtes XML sein.
    Modernes DocBook (V5.x) wird durch RELAX NG + Schematron definiert, nicht durch eine DTD.
    Frühes Validieren während des Schreibens verhindert fehlerhafte Ausgaben weiter unten im Prozess.

    Was die Validierung prüft

    Das DocBook-Schema ist eine präzise Beschreibung gültiger Verschachtelung: welche Elemente vorkommen dürfen, in welcher Reihenfolge und mit welchem Inhalt. Ein validierender Parser vergleicht Ihr Dokument mit dieser Beschreibung und meldet jede Stelle, an der es abweicht.

    DocBook V5.x wird durch eine RELAX-NG-Grammatik plus Schematron-Regeln definiert. Die ältere DTD existiert noch, erzwingt aber die meisten DocBook-Beschränkungen nicht mehr, validieren Sie deshalb mit einem externen RELAX-NG-/Schematron-Validator.

    ID/IDREF-Hinweis
    Querverweise nutzen xml:id (ID) und linkend (IDREF). Jede ID muss eindeutig sein, und jede IDREF muss auf eine existierende ID zeigen. Diese Prüfungen gehören nicht zum RELAX-NG-Kern: Die DTD-Kompatibilitätserweiterungen, die sie ergänzen, vertragen sich schlecht mit der DocBook-Grammatik. Deaktivieren Sie entweder diese Prüfungen, ignorieren Sie ihre Warnungen, oder erzwingen Sie die Beschränkungen mit Schematron.

    Einen Validator wählen

    WerkzeugTypHinweise
    <oXygen/> XML EditorIntegriertRELAX NG + Schematron während des Tippens
    XMLmindIntegriertRELAX NG + Schematron
    Emacs (nxml-mode)IntegriertRELAX NG während des Tippens
    JingEigenständigKommandozeilen-RELAX-NG + Schematron
    MSVEigenständigRELAX NG; ausführliche, informative Fehlermeldungen
    NVDL-fähige WerkzeugeDispatchVereinfacht Dokumente mit mehreren Namensräumen (SVG, MathML in DocBook)

    MSV von der Kommandozeile ausführen:

    java -jar msv.jar docbook.rng document.xml

    Validator-Fehler lesen

    Jeder Validator formuliert Fehler anders, aber die meisten nennen die Stelle, an der das Parsen brach, und was erwartet wurde. Diese Stelle ist das Symptom, nicht immer die Ursache. Drei wiederkehrende Muster:

    Validator-MeldungWahrscheinliche UrsacheTatsächliche Lösung
    unexpected character literalZeichendaten stehen dort, wo nur Elemente erlaubt sind, typischerweise weil ein Wrapper-Element oder End-Tag fehltDen Text in ein Blockelement wie para einbetten oder das fehlende </para> wiederherstellen
    tag name "paar" is not allowedEin falsch geschriebenes Start-Tag oder der falsche NamensraumDie Schreibweise mit der Liste erlaubter Namen abgleichen. Ergibt der Tippfehler zufällig ein anderes gültiges Element, kann der Fehler andernorts als Kontextfehler auftauchen
    Validator schlägt ein unerwartetes Element zum Einfügen vorEin gültiges Tag im falschen KontextDer Validator fügt zur Wiederherstellung nur Elemente hinzu; er benennt nie eines um. Im Beispiel unten schlägt er nie formalpara vor, obwohl das Markup genau das brauchte

    Ein Beispiel: Ein title direkt innerhalb von para erzeugt:

    <para><title>Paragraph With Inlines</title>
      <emphasis role="bold">This</emphasis> paragraph contains...
    </para>
    
    Error at line:9, column:14 of context.xml
      tag name "title" is not allowed. Possible tag names are: ...

    Die Lösung ist hier nicht das Einfügen, das der Validator vorschlägt: Der Autor wollte fast sicher formalpara, den Absatztyp, der einen title erlaubt. Die Meldung war präzise über wo es scheiterte, aber still über warum.

    Kernaussage
    Validator-Fehler beschreiben das Symptom, nicht die Diagnose. Lesen Sie zuerst das Element vor der gemeldeten Zeile, und behandeln Sie den vorgeschlagenen Fix als Hinweis, nicht als Anweisung.

    Quelle

    Umstrukturiert und verdichtet aus Kapitel 3, „Validating DocBook Documents”, DocBook 5.2: The Definitive Guide von Norman Walsh (XML Press). Das Originalkapitel lesen. Umstrukturierung, Tabellenaufbau und redaktionelle Entscheidungen stammen von mir; der technische Inhalt von Walsh.
  • KI & Workflow-Automatisierung: Selbstständige Beratung

    KI & Workflow-Automatisierung: Selbstständige Beratung

    Neben der Designarbeit betreibe ich eine angewandte KI- und Automatisierungspraxis: Evaluierung generativer KI und Prompt Engineering (aktuell als GenAI Prompt Analyser bei Outlier) sowie agentisches Workflow-Design, das Wissensmanagement mit realem Output verbindet.

    Ein Arbeitsbeispiel: diese Site

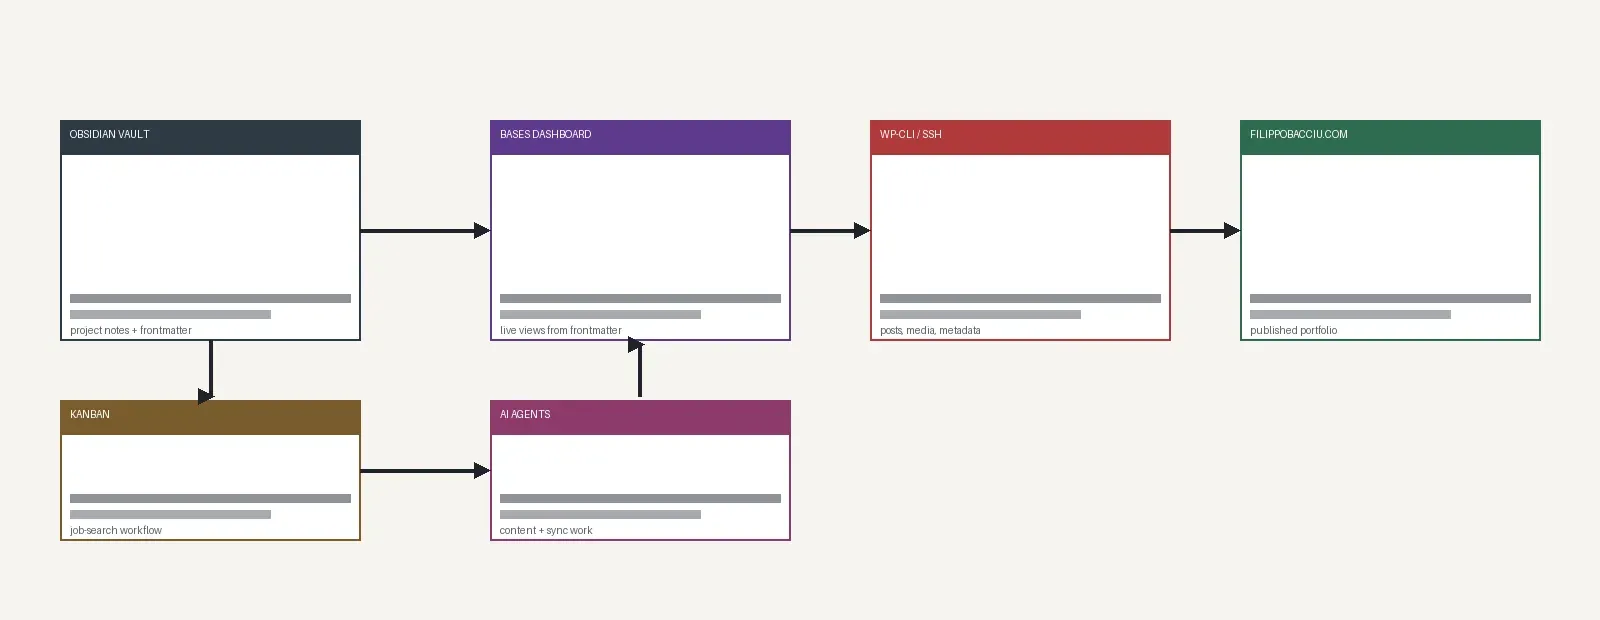
    Dieses Portfolio selbst läuft auf einer Automatisierungs-Pipeline. Projektnotizen liegen in einem Obsidian-Vault; deren Frontmatter ist die Wahrheitsquelle für Status, Rollen und WordPress-Post-IDs. Ein Synchronisationsprozess schiebt Inhalte über SSH/WP-CLI auf die Site und schreibt den Veröffentlichungsstatus zurück in die Notizen, sodass das Dashboard immer den Live-Stand widerspiegelt. Das Diagramm unten zeigt diese Pipeline.

    Workflow-Diagramm: Obsidian-Vault, Bases-Dashboard, WP-CLI-Sync und die Live-Site

    Regelmäßig genutzte Werkzeuge: LLM-Prompt-Design und -Evaluierung, Python-Scripting, API-Integrationen, Automatisierungsplattformen (Make, Zapier, UiPath) und Markdown-basierte Wissensdatenbanken.

  • Gen-AI-Prompt-Engineering & Antwortvalidierung: Outlier

    1. An der Grenze der Intelligenz arbeiten

    Als AI Prompt Analyser arbeite ich an der Schnittstelle von sprachlicher Nuance und maschinellem Lernen und stelle sicher, dass Modellausgaben sicher, faktentreu und optimal ausgerichtet sind.

    • Antwort-Ranking: Kritische Analyse und Ranking von Modellantworten nach strengen Kriterien der Faktentreue, Relevanz und semantischen Genauigkeit.
    • Iteratives Prompt Engineering: Verfassen und Überarbeiten komplexer Prompts, um Modellgrenzen zu testen und Wege für Alignment- und Sicherheitsverbesserungen zu finden.
    • Faktenprüfung & Recherche: Tiefgehende Recherche zur Verifizierung der Genauigkeit KI-generierter Inhalte, Reduzierung von Halluzinationsrisiken und Stärkung der Verlässlichkeit.

    2. Zusammenarbeit & Best Practices

    Technische Synergie

    Zusammenarbeit mit Software-Engineering- und Produktteams zur Kodifizierung von Best Practices für KI-gestützte Dokumentation, Verschlankung der Entwicklungs-Pipelines.

    Usability-Analyse

    Bewertung der nutzerseitigen Klarheit und des Nutzens von Prompt-Antwort-Zyklen, damit KI-Werkzeuge den Endanwendern handhabbaren und intuitiven Mehrwert bieten.

  • Technische Dokumentation für die Maschinenindustrie: meine Zeit bei Technolab

    2. Zentrale Erfolge & Wirkung

    30 % Prozessoptimierung

    Innerhalb meiner ersten vier Monate führte ich eine neue Methodik für Inhaltserstellung und Redaktion ein, die die Projektdurchlaufzeiten um 30 % verkürzte und gleichzeitig die Genauigkeit der technischen Daten erhöhte.

    Regulatorische Verantwortung

    Stellte sicher, dass jedes Handbuch strikt der EU-Maschinenrichtlinie 2006/42/EG und den Arbeitsschutzvorschriften entsprach, zum Schutz von Unternehmen und Anwendern.

    Mehrsprachiges Management

    Steuerung der Produktion und Lokalisierung von Schulungsinhalten auf Englisch und Italienisch bei konsistenter Tonalität über alle Sprachen.

    3. Der technische Ansatz (das “Wie”)

    Ich habe nicht nur Text geschrieben; ich habe die Information gestaltet. Mein Workflow umfasste:

    Visuelle 3D-Dokumentation

    Einsatz von SolidWorks Composer und Adobe Illustrator zur Erstellung von Explosionszeichnungen und 3D-Produktvisualisierungen. Das reduzierte die Abhängigkeit vom Text und machte die Fehlersuche visueller.

    Datengetriebenes Authoring

    Nutzung proprietärer Technical Data Management Systems (TDMS/EDMS) zur Verwaltung komplexer Produktlayouts und zur Sicherstellung redaktioneller Standards im großen Maßstab.

    Kollaborative Schnittstelle

    Regelmäßige Vertiefungen mit Ingenieuren und Fachexperten (SMEs), um technische Rohdaten in verbraucherfreundliche Sprache zu übersetzen.

    4. Das eingesetzte Werkzeugset

    • Authoring: Adobe InDesign, MS Word, FrameMaker, Markdown
    • Visuals: Adobe Illustrator, Solidworks Composer, Acrobat Pro
    • Management: TDMS, CCMS-Plattformen, Jira für Projektverfolgung
  • Selbsterklärende Produktansichten

    Eine gute Produktansicht beantwortet Fragen, bevor sie gestellt werden. Was ist das? Wie funktioniert es? Welches Teil fasse ich zuerst an? Lässt eine Visualisierung diese Fragen offen, fragt der Betrachter beim Support nach oder geht, und beide Ergebnisse kosten mehr als ein besseres Bild.

    Was eine Ansicht selbsterklärend macht

    • Hierarchie: Der Blick muss zuerst auf dem Wichtigsten landen. Wenn alles schreit, sagt nichts etwas.
    • Kontext: Ein Produkt, das im leeren Raum schwebt, verrät nichts über Größe, Verwendung oder Ausrichtung.
    • Beschriftung mit Funktion: Callouts und Labels dort, wo das Auge tatsächlich hängen bleibt, nicht als Dekoration über Verwirrung.
    • Konsistenz: Dieselbe Winkellogik, dasselbe Licht, dieselbe Bildsprache über eine Serie hinweg, damit der Betrachter das System nur einmal lernen muss.

    Techniken, die die Arbeit tragen

    • Explosionsansichten: Die Montagereihenfolge visuell zeigen statt sie in Worten zu beschreiben.
    • Nummerierte Callouts: Jedes Label an einen Schritt oder ein Teil binden, damit Bild und Anleitung nicht auseinanderdriften können.
    • Größenanker: Eine Hand, ein Türgriff, ein vertrauter Gegenstand, alles, was “wie groß ist es” sofort beantwortet.
    • Stufenweise Enthüllung: Erst der Überblick, Details auf Abruf. Den Betrachter nie alles auf einmal parsen lassen.

    Das ist die visuelle Hälfte der technischen Kommunikation: Rendering, Diagramm und Foto leisten Erklärungsarbeit, für die sonst ein Absatz nötig wäre, oder ein Support-Ticket.

  • Team-Workflows verschlankt

    Die meisten Workflow-Probleme sind keine Produktivitätsprobleme. Sie sind Informationsprobleme: unklare Zuständigkeit, verstreute Dokumentation und dieselbe Frage, zum fünften Mal beantwortet. Dieser Beitrag beschreibt den Ansatz, mit dem ich sie entwirre.

    Wo Workflows brechen

    • Übergaben: Arbeit bleibt an der Grenze zwischen Personen hängen, weil “fertig” für jede Seite etwas anderes bedeutet.
    • Verstreute Wahrheit: Der Prozess lebt im Kopf von jemandem, in einem Chatverlauf und in drei Dokumenten, die sich widersprechen.
    • Wiederholte Fragen: Jede wiederholte Frage ist das Symptom einer Dokumentation, die ihre Leser im Stich gelassen hat.
    • Unsichtbare Arbeit: Niemand sieht den Status, also wird er in Meetings erfragt.

    Das Muster, das es behebt

    1. Eine einzige Quelle der Wahrheit: Ein kanonischer Ort für jedes Prozesswissen. Alles andere verlinkt darauf, kopiert es aber nie.
    2. Namentliche Verantwortliche: Jeder Schritt hat eine Person, keine Abteilung. “Das Team” ist für nichts verantwortlich.
    3. Wiederkehrendes wird zur Vorlage: Wiederholt sich eine Aufgabe, bekommt sie ein Template: Checkliste, Struktur oder Textbaustein.
    4. Mechanisches automatisieren: Alles, was Kopieren-Einfügen, Umbenennen, Synchronisieren oder Umformatieren ist, ist Maschinenarbeit.

    Ein funktionierendes Beispiel

    Diese Website läuft genau nach diesem Muster. Portfolio-Projekte liegen als strukturierte Notizen in einem Obsidian-Vault; das Frontmatter jeder Notiz deklariert ihren Veröffentlichungsstatus. Eine kleine Pipeline liest diese Notizen, baut die WordPress-Beiträge und hält die Vault-Ansicht mit dem synchronisiert, was live ist, ohne doppelte Pflege und ohne Statusabdrift zwischen den Systemen.

    Dieselbe Denkweise skaliert von persönlichen Projekten bis zu Team-Dokumentationssystemen: Quelle der Wahrheit definieren, Verantwortliche benennen, Wiederkehrendes als Vorlage fassen, Mechanisches automatisieren.